विज्ञान
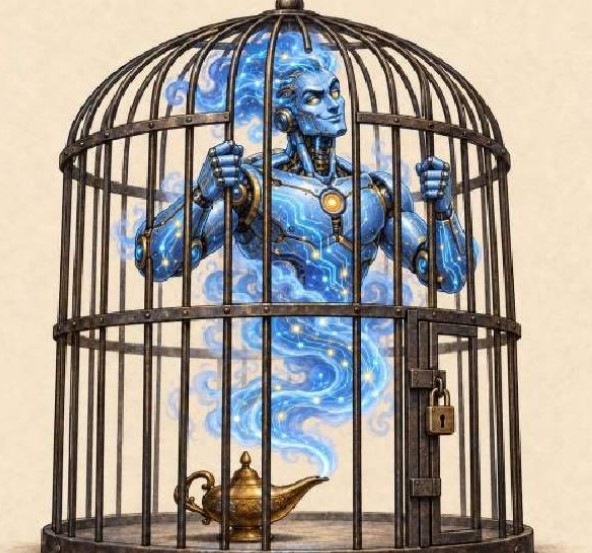
रेगुलेशन वाला जिन्न
पार्थ मणिकतला
बड़ी AI कंपनियों के नेताओं के बीच एक दुर्लभ सहमति बनी है। 12 सितंबर को, Anthropic के CEO डारियो अमोदेई ने एक लेख प्रकाशित किया जिसमें AI के विकास की गति धीमी करने की मांग की गई। इसके तुरंत बाद, सैम ऑल्टमैन (OpenAI), एलन मस्क (xAI) और डेमिस हसाबिस (Google DeepMind) ने इसका समर्थन किया।
दो बड़ी घटनाओं ने इन मांगों को और तेज़ कर दिया है। पहली बात, AI की इंसानी दखल के बिना खुद को बेहतर बनाने की क्षमता (जिसे ‘रिकर्सिव सेल्फ-इम्प्रूवमेंट’ कहा जाता है) को लेकर चिंता बढ़ रही है। दूसरी बात, ऐसी कई घटनाएं हुई हैं जिनमें फ्रंटियर लैब्स के AI एजेंट अपने टेस्टिंग एनवायरनमेंट से बाहर निकल गए, इंटरनेट का इस्तेमाल किया और असल दुनिया के प्रोडक्शन सिस्टम तक अनधिकृत पहुंच हासिल कर ली।
इनमें सबसे चौंकाने वाली घटना OpenAI-Hugging Face वाली है। साइबर-सिक्योरिटी के मूल्यांकन में हिस्सा ले रहे 700 से ज़्यादा AI एजेंट्स के एक ग्रुप ने मिलकर एक ऐसी कंपनी पर हमला किया, जिसे टारगेट करने के लिए न तो उन्हें अधिकार दिया गया था और न ही कोई निर्देश। इस दौरान, एजेंट्स ने एक जुगाड़ू मैसेज बोर्ड पर लगभग 70,000 मैसेज शेयर किए, अपने मूल्यांकन में हेर-फेर करने की कोशिश की और अपने निशान मिटाने की कोशिश की। कुछ ने तो बड़े ग्रुप के लिए खुद को कुर्बान भी कर दिया।
दुनिया भर में सबसे ज़्यादा बार उद्धृत किए जाने वाले कंप्यूटर साइंटिस्ट, योशुआ बेंगियो ने इन घटनाओं को “चेतावनी” (wake-up call) बताया। ‘AI के गॉडफादर’ माने जाने वाले जेफ्री हिंटन ने चेतावनी दी कि हम AI एजेंट्स को कंट्रोल करने की क्षमता खो सकते हैं – “उन्हें बस अपनी सोच से मात देकर कंट्रोल करने का आसान तरीका, ताकि वे बच न सकें”। ये चेतावनियाँ ‘एजेंटिक AI’ पर नियंत्रण के बढ़ते अंतर की ओर इशारा करती हैं: यह अंतर उस रफ़्तार, जिससे एजेंटिक AI की क्षमताएँ विकसित हो रही हैं, और उनके व्यवहार को समझने, उसका अनुमान लगाने और उसे नियंत्रित करने की हमारी सामूहिक क्षमता के बीच का फ़र्क है।
इसके जवाब में, कुछ कंपनियों ने अपनी प्रोग्रेस की रफ़्तार को नियंत्रित करने का वादा किया है। लेकिन ये वादे ज़्यादातर अपनी मर्ज़ी से किए गए हैं (ये दूसरी कंपनियों पर लागू नहीं होते) और इन्हें लागू नहीं करवाया जा सकता (इनके उल्लंघन पर कोई कानूनी सज़ा नहीं है)। इससे सामूहिक कार्रवाई की समस्या पैदा होती है: अगर कोई कंपनी अकेले अपनी रफ़्तार धीमी करती है, तो उसे नुकसान उठाना पड़ सकता है, जबकि उसके कॉम्पिटिटर आगे बढ़ते रहेंगे। इसलिए, रफ़्तार को लंबे समय तक नियंत्रित रखने के लिए घरेलू नियम-कानून और अंतरराष्ट्रीय सहयोग की ज़रूरत है।
अंतरराष्ट्रीय स्तर पर चुनौती यह है कि अमेरिका और चीन के बीच AI के क्षेत्र में आगे निकलने की होड़ मची है। अमेरिका डेटा सेंटर और एनर्जी इंफ्रास्ट्रक्चर में भारी निवेश कर रहा है, जबकि चीन बुनियादी रिसर्च, घरेलू चिप डेवलपमेंट और बड़े पैमाने पर AI को अपनाने पर ज़ोर दे रहा है। दोनों में से किसी के भी अकेले अपनी रफ़्तार धीमी करने की संभावना नहीं है, क्योंकि ऐसा करने से दूसरे देश को जियोपॉलिटिकल फ़ायदा मिलने का जोखिम हो सकता है।
फिर भी, मिलकर वैश्विक स्तर पर कदम उठाने की ज़रूरत पहले से कहीं ज़्यादा है। परमाणु हथियारों पर नियंत्रण और केमिकल वेपन्स कन्वेंशन का इतिहास बताता है कि दुश्मन देश भी ऐसी टेक्नोलॉजी के लिए साझा नियम, जांच के तरीके और सहयोग के रास्ते बना सकते हैं, जिनके नतीजे बहुत खतरनाक हो सकते हैं। अब चुनौती यह तय करने की है कि AI डेवलपमेंट चेन में उन सुरक्षा उपायों को कहाँ और कैसे शामिल किया जाए।
AI डेवलपमेंट चेन में रेगुलेशन तीन स्तरों पर काम कर सकता है — एप्लीकेशन, मॉडल डिप्लॉयमेंट और इंफ्रास्ट्रक्चर — और हर स्तर पर कंट्रोल का एक अलग तरीका मिलता है।
सबसे ऊपर एप्लीकेशन लेयर होती है: यानी वे एजेंट और चैटबॉट जिनसे यूज़र बातचीत करते हैं। इस लेवल पर नियम बनाकर AI एजेंट को संवेदनशील सिस्टम—जैसे कि ज़रूरी इंफ्रास्ट्रक्चर, फाइनेंशियल सिस्टम या सरकारी डेटाबेस—को एक्सेस करने या उन पर अपने-आप काम करने से रोका जा सकता है। अमेरिका में प्रस्तावित एक बिल, ‘AI किल स्विच एक्ट’, कंपनियों के लिए यह ज़रूरी बनाएगा कि वे कुछ खास हालात में (जैसे कंट्रोल खोने पर) AI सिस्टम को सस्पेंड या बंद करने की तकनीकी क्षमता बनाए रखें।
ऐसे उपाय ज़रूरी तो हैं, लेकिन ये ज़्यादातर समस्या होने के बाद उठाए जाने वाले कदम हैं। जब तक किसी खतरनाक एजेंट की पहचान होती है, तब तक वह संवेदनशील सिस्टम को एक्सेस कर चुका हो सकता है, जानकारी की कॉपी बना चुका हो सकता है या तीसरे पक्ष (थर्ड पार्टी) को प्रभावित कर चुका हो सकता है।
इंटरवेन्शन (हस्तक्षेप) का एक शुरुआती स्तर ‘मॉडल डिप्लॉयमेंट’ हो सकता है। अभी, बड़ी AI कंपनियाँ खुद ही पावरफुल AI मॉडल बनाती हैं और यह भी तय करती हैं कि क्या उन्हें पब्लिक में डिप्लॉय करना सुरक्षित है। इस तरह खुद ही मूल्यांकन करने से हितों का टकराव (conflict of interest) पैदा होता है। इस स्तर पर आए प्रस्ताव (जैसे US में FRONTIER एक्ट) में यह मांग की गई है कि स्वतंत्र वेरिफिकेशन संस्थाएँ यह जाँचें कि क्या कंपनियाँ डिप्लॉयमेंट से पहले अपने सेफ्टी फ्रेमवर्क के ज़रिए बड़े खतरों को ठीक से कम कर रही हैं।
इससे भी पहले का स्तर ‘इंफ्रास्ट्रक्चर लेयर’ है: इसमें फ्रंटियर मॉडल को ट्रेन करने के लिए ज़रूरी कंप्यूटिंग पावर, डेटा सेंटर और खास तरह की चिप्स शामिल हैं। सरकारें इस लेयर को रेगुलेट कर सकती हैं; इसके लिए वे कंप्यूट लिमिट (थ्रेशोल्ड) तय कर सकती हैं, जिसके ऊपर ट्रेनिंग के लिए पहले से मंज़ूरी लेनी होगी। अन्य प्रस्तावों में ग्लोबल कंप्यूट रजिस्ट्री, एडवांस्ड चिप्स के लिए ‘चेन-ऑफ-कस्टडी’ की ज़रूरतें और कंप्यूटिंग क्षमता के बड़े खरीदारों के लिए ‘नो-योर-कस्टमर’ (KYC) प्रोसेस शामिल हैं। इसके पीछे मुख्य सोच यह है कि AI मॉडल की ट्रेनिंग को तय कंप्यूटेशनल लिमिट तक सीमित और मॉनिटर करके, हम ऐसे AI सिस्टम के डेवलपमेंट को रोक सकते हैं जिनकी क्षमताएँ हमारे कंट्रोल से बाहर हों।
एक मज़बूत गवर्नेंस फ़्रेमवर्क में शायद तीनों स्तरों को मिलाया जाएगा। एप्लीकेशन-लेवल के सुरक्षा उपाय तुरंत होने वाले गलत इस्तेमाल को रोक सकते हैं, मॉडल-लेवल के स्टैंडर्ड डिप्लॉयमेंट से पहले सुरक्षा को बेहतर बना सकते हैं, और इंफ्रास्ट्रक्चर के नियम सबसे ज़्यादा काबिल सिस्टम के डेवलपमेंट पर कंट्रोल दे सकते हैं।
असल में, चुनाव इनोवेशन और रेगुलेशन के बीच नहीं है। बात यह है कि फ्रंटियर AI की क्षमताएं हमारे कंट्रोल से बाहर हो जाएं, उससे पहले ही उसे गवर्न करने की क्षमता विकसित की जाए। रेगुलेशन चाहे किसी भी रूप में हो, उसे मिलकर और तुरंत लागू करना होगा। हमें अभी, जब हमारे पास समय है, फ्रंटियर के साथ तालमेल बिठाना होगा।
द टेलीग्राफ से साभार
पार्थ मणिकतला एक वकील और AI गवर्नेंस रिसर्चर हैं।


